Ein ganzes 3D-Spiel von einem lokalen 35B-Modell bauen lassen – und was wirklich den Unterschied gemacht hat
Stand 6. November 2026 (Hauptteil 3. November; Nachtrag und Anhang G vom 6. November) · Umfang: alle Tests und Benchmarks seit Anfang Oktober 2026 · Messdaten und Rohprotokolle liegen im Repo (Pfade im Anhang); Detailkapitel in den Anhängen A bis G
Kurzfassung. Ein lokales Modell (Qwen3.6-35B-A3B, 4-Bit, auf einer Gaming-Grafikkarte mit 12 GB) hat unter dem Agenten-Harness OpenCode ein vollständiges 3D-Survival-Spiel im Browser gebaut – von der Insel bis zum Sieg-Bildschirm. In 20 gewerteten Modell-Läufen und gut sechs Stunden Wandzeit auf der GPU wurden 16 Arbeitspakete umgesetzt; 14 davon grün im ersten Versuch (je nach Zählweise 13 bis 15, siehe 4.3). Zwei Pakete mussten wegen Fehlern im Prüfstand wiederholt werden, und eines (P3-2) scheiterte zweimal und wurde mit einem 5-Zeilen-Handfix von mir fertig. Entscheidend für die beobachtete Zuverlässigkeit war das Zusammenspiel von Modell und drei Dingen drumherum (eine Ablation, die den Anteil trennt, gibt es nicht): kleine Pakete mit wörtlich vorgegebenen Formeln, versteckte Abnahmetests und ein Prüfstand, dem man vertrauen kann. Auf der Kostenseite war der lokale Weg nicht billiger an Claude-Tokens, sondern vermutlich teurer – dazu unten die ehrlichen Zahlen.
Nachtrag 6. November: Auf sechs neuen, kleinen Aufgaben löste Claude direkt alle sechs, Hybrid und lokal autonom je vier (Abschnitt 10, Anhang G). Das lokale 35B ist ein brauchbarer Implementierer unter kontrollierten Bedingungen; das ist kein Beleg dafür, dass es einen Cloud-Agenten allgemein ersetzt.
1. Die Frage
Der Auftrag kam als langer Prompt: „Lost Island – 3D Browser Survival Game“, fünf Phasen (Grundwelt, Ressourcen, Survival, Crafting und Spielziel, Atmosphäre), Three.js, TypeScript, Vite, kein Backend, keine externen Assets. Das Ganze sollte lokal gebaut werden: OpenCode als Coding-Agent, ein Qwen-35B als Modell.
Die eigentliche Frage dahinter: Lohnt sich der Einsatz lokaler LLMs gegenüber Claude? Dazu wurde nicht nur gebaut, sondern mitgemessen – Claude-Tokens je Phase, GPU-Zeit, Fehlversuche, Nachschübe. Dieser Artikel fasst das zusammen, einschließlich der Vorgeschichte (warum überhaupt OpenCode und dieses Modell) und der Fehler, die uns unterwegs selbst unterlaufen sind. Er behauptet bewusst weniger, als die Daten hergeben.
2. Aufbau
Hardware. Ein Gaming-PC mit einer Grafikkarte, von der nur etwa 12 GB VRAM nutzbar sind. Er läuft nicht dauerhaft: Eine Ablaufkette weckt ihn per Wake-on-LAN, startet die Läufe, schaltet ihn danach wieder ab und prüft per Ping, dass er wirklich aus ist. Ollama bedient das Modell, ein Router davor vergibt Reservierungen („Pachtschein“), damit sich keine zwei Jobs in die Quere kommen.
Modell. qwen3.6-35b-a3b:UD-Q4_K_M – ein Mixture-of-Experts mit rund 3 Milliarden aktiven Parametern, 23 GB groß, gemessen etwa 19 bis 24 Token/s (eine frühere Notiz nennt ~34, gemessen wurden 19,2 bzw. 21,3 und nach dem RAM-Takt-Update 23,6; Anhang B), Kontext 64k, Denkmodus aus.
Auf einer 12-GB-Karte liegt es nur teilweise im VRAM; das MoE-Design macht das erträglich.
Harness. OpenCode in einem Wegwerf-Container ohne Internet. Das Modell darf Dateien lesen und schreiben, aber nicht das Orakel (die versteckten Abnahmetests) sehen. Stattdessen
ruft es einen Befehl pruefe auf, der das Gate in einem zweiten Container startet und nur das Ergebnis zurückgibt.
Gate. Fünf Stufen, jede muss grün sein: TypeScript-Prüfung → Produktions-Build → Projekt-Tests → versteckte Abnahmetests → Browser-Test mit Playwright gegen den gebauten Stand (WebGL per Software-Rendering, etwa 10 Bilder/s). Übersprungene Tests zählen als rot. Das Orakel kopiert das Gate selbst in den Container, das Projekt kann es nicht ausblenden.
Übernahme. Ist das Gate grün, wird das Ergebnis automatisch ins Spiel-Repo übernommen und committet. Rot heißt: nichts übernommen.
3. Vorgeschichte: Warum OpenCode und warum dieses Modell?
Vor dem Spiel standen mehrere Messreihen. Sie sind der Grund für die Wahl und liefern die Lehren, die später gegolten haben.
3.1 Modellvergleich auf einer 25-Aufgaben-Suite
Stand 10.10.2026. Die spätere Einzeltabelle vom 15.10. (alle Arme am selben Tag, mit weiteren Armen wie Strata und Bonsai) steht in Anhang B; dort kommt Sonnet auf 24/25, das 35B bleibt bei 20/25. Ich habe die Gesamtzählung der 15.10.-Tabelle gegen die Rohdatei nachgezählt: sie stimmt.
| Arm | Modell | Größe | Strategie | bestanden | Modellzeit |
|---|---|---|---|---|---|
| K | qwen3-coder:30b | 18 GB | nackt | 15/25 = 60 % | 7,9 min |
| O | qwen3.6-35b-a3b | 23 GB | nackt | 20/25 = 80 % | 11,9 min |
| P | qwen3.6-35b-a3b | 23 GB | best-of-4 | 21/25 = 84 % | 25,3 min |
| M | qwen3-coder-next (80B) | 48 GB | nackt | 21/25 = 84 % | 16,6 min |
| N | qwen3-coder-next (80B) | 48 GB | best-of-4 | 23/25 = 92 % | 27,5 min |
| F | claude-sonnet-5 | – | nackt | 22/25 = 88 % | 3,6 min |
Gepaart: 35B gegen 30B p = 0,062 (5 Aufgaben nur das 35B, 0 nur das 30B), 35B gegen 80B p = 1,00. Zwischen dem 35B und dem 80B ließ sich kein Unterschied nachweisen (25 Aufgaben, p = 1,00; das heißt nicht, dass beide gleich leistungsfähig sind) – bei halber Größe. Der 80B passt auf dieser Karte nur zu rund 23 % in den VRAM, der Prefill läuft auf der CPU mit ~64 Token/s; er schied für Agenten-Läufe aus.
3.2 Harness-Vergleich: OpenCode gegen Qwen Code gegen den eigenen Agenten
Das Modell allein sagt wenig – der Harness entscheidet, ob es seine Fähigkeit auch einsetzen kann. Gemessen wurde mit einer echten Aufgabe (Fehlerbehebung in einem Finanz-Projekt) und danach mit drei Aufgaben
aus einem zweiten Projekt (ghost-terminal).
| Serie | Arm | Ergebnis | Anmerkung |
|---|---|---|---|
| R1, Orakel lesbar | local 2/3 · Qwen Code 2/3 · OpenCode 3/3 | regelkonform nur 2/3 · 1/3 · 0/3 | die CLIs lasen das Orakel trotz Verbot – der Unterschied war Regeltreue, nicht Können |
| R2, Orakel nicht lesbar | OpenCode 3/3 · local 1/3 · Qwen 0/3 | konfundiert | die CLIs liefen ohne ausgeschalteten Denkmodus, der eigene Agent mit |
| R2b, Denken aus | OpenCode 2/3 · Qwen 1/3 · local 0/3 | nicht unterscheidbar | Vorab-Regel verfehlt |
| R2c, nach Lesefix | local 2/3 | n=3, Demonstration | ein Lesefehler im eigenen Agenten war behoben |
| Echtserie, 3 Aufgaben × 3 | OpenCode × 35B: 8/9 | Vorab-Regel „brauchbar“ erfüllt | alle grünen Diffs fachlich in Ordnung |
| gleiche Aufgaben | Qwen Code × 35B: 3/9 | 6× Textende ohne Tool-Aufruf | davor behobener Adapter-Fehler (doppelte Tool-Call-IDs) |
Weitere Kandidaten fielen am Vorfilter durch:
- gemma4:12b: 0/9. Jede Sitzung endete nach etwa 12 Sekunden: Das Modell kündigte in Text an, statt ein Werkzeug aufzurufen (18 von 18 Antworten ohne Tool-Call).
- ornith-1.0-9b: 2/9, dreimal wurden die Tests entgegen dem Verbot verändert.
- qwen3.5:9b: die Probe scheiterte (Befehl als Markdown-Block statt als Tool-Aufruf).
- qwen3:14b: deckelt den Kontext bei 40 960 Token – 64k unmöglich.
- 27B und Coder-30B in IQ3: das dichte 27B lief mit 1,8 Token/s (der KV-Cache sprengt die 12 GB), beim Coder-30B kam der Tool-Aufruf als Text.
Fazit der Vorgeschichte: Auf dieser Karte mit 64k Kontext trägt unter den getesteten Modellen nur das 35B-MoE, und unter den getesteten Harnesses war OpenCode klar am zuverlässigsten. Ein einzelner erfolgreicher Tool-Aufruf im Vorabtest sagt dagegen nichts über die Agententauglichkeit – erst die Probe im echten OpenCode-Kontext tut das. Alle diese Serien sind n=3 bzw. n=9 in einem Projekt: Demonstrationen, keine Rangfolgen.
4. Das Experiment: Lost Island in 16 Paketen
4.1 Die Methode („das Rezept“)
Aus Phase 1 stammt das Verfahren, das sich bewährt hat:
- Kleine Pakete, ein bis zwei Dateien. Aufgeteilt in Logik (reine Funktionen, ohne Rendering, ohne DOM) und Einbindung (in
main.tsverdrahten). - Mathe und Konventionen wörtlich im Aufgabentext. Das Modell soll nicht raten, in welche Richtung eine Figur läuft oder wie schnell der Hunger sinkt.
- Versteckte Abnahmetests (das Orakel), die das Modell nie sieht, plus ein Browser-Test.
- Referenzlösung und Mutationsproben, bevor GPU-Zeit fließt: Ein Test, der eine falsche Lösung nicht erkennt, prüft nichts.
- Automatische Übernahme bei Grün, ein sauberer Commit je Paket.
Claude schreibt dabei Verträge, Orakel und Referenzen; das lokale Modell schreibt den Code.
4.2 Das Ergebnis
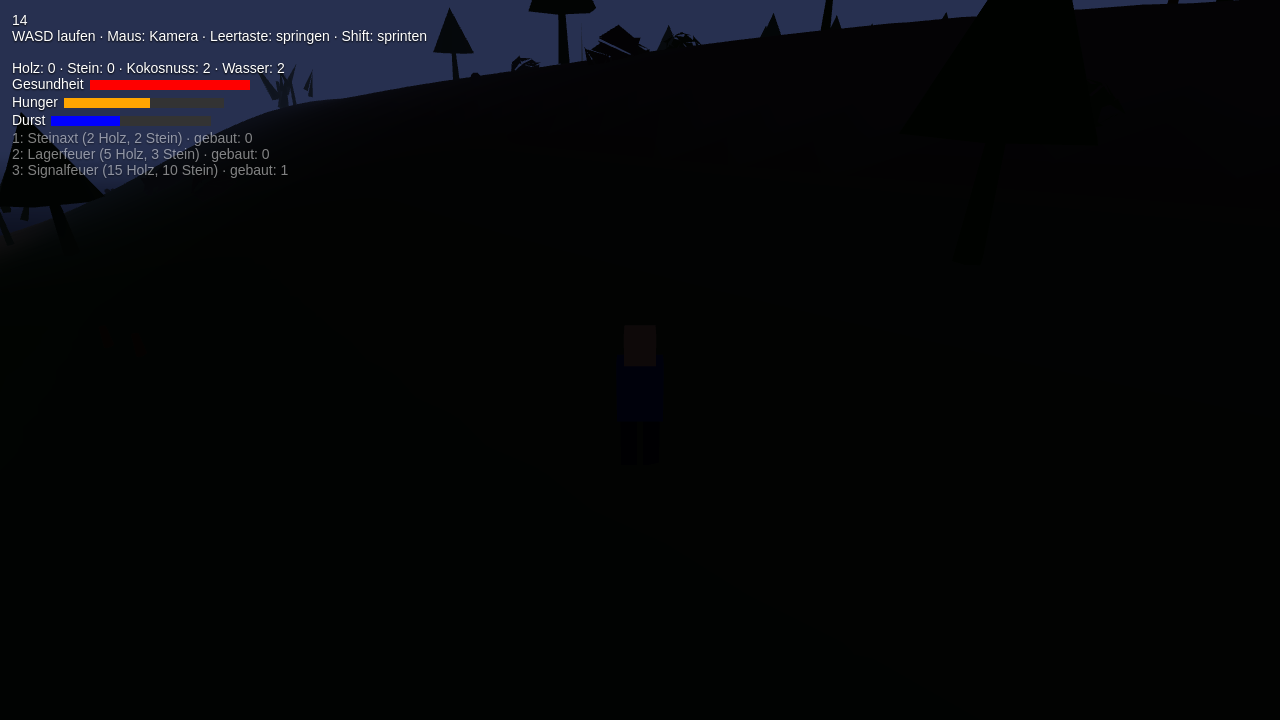
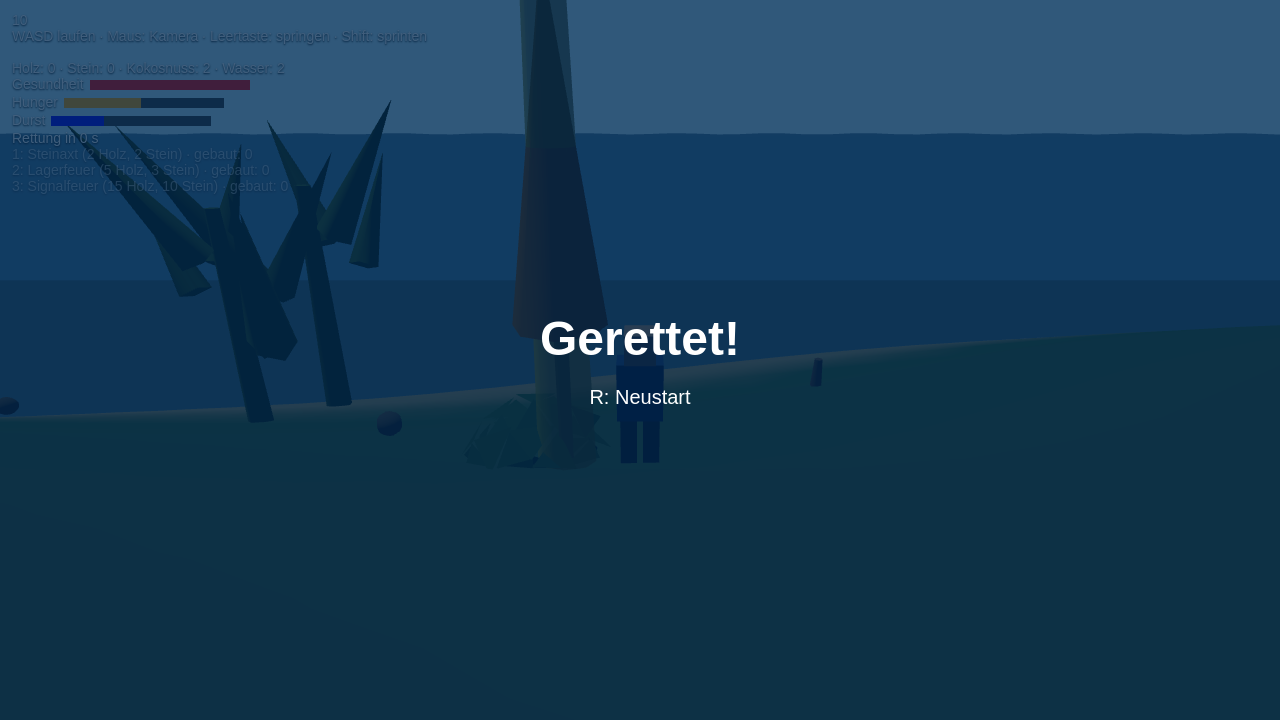
Das Spiel läuft: Insel mit Wasser, Himmel, Nebel, Palmen und Bäumen, Spielfigur mit Kamera und HUD, Ressourcen zum Einsammeln (E), Inventar, Überlebenswerte (Gesundheit, Hunger, Durst) mit Game Over, Crafting von Steinaxt, Lagerfeuer und Signalfeuer (Tasten 1/2/3), eine markierte Rettungsstelle, Sieg nach zehn Sekunden Signalfeuer, Tag-Nacht-Zyklus, Wellen, wiegende Pflanzen, Web-Audio-Geräusche ohne Dateien. Ein Browser-Test spielt es bis zum Sieg durch, ohne Konsolenfehler.
4.3 Alle Läufe
| Paket | Inhalt | Ergebnis | Nachschübe | Antworten | Wandzeit |
|---|---|---|---|---|---|
| P1a (ganz) | Terrain, Wasser, Himmel, Vegetation | rot ×2 | 1–2 | 38–40 | 15 / 41 min |
| P1a-1 → P1a-2 | Terrain-Mathe, danach Darstellung | grün (P1a-2 erst im 2. Anlauf, der 1. wurde wegen eines Harness-Fehlers verworfen) | 0 | 32 / 52 | 13 / 37 min |
| P1b (ganz) | Figur, Steuerung, Kamera, HUD | rot | 6 | 36 | 23 min |
| P1b-1 → P1b-2 | Logik, danach Einbindung | grün, je 1. Versuch | 0 | 39 / 51 | 18 / 18 min |
| P2-1 | Inventar und Ressourcen (Logik) | grün | 1 | 35 | 13 min |
| P2-2 | Ressourcen im Spiel | grün | 1 | 24 | 9 min |
| P3-1 | Überlebenswerte (Logik) | grün | 0 | 33 | 15 min |
| P3-2 | Überlebenswerte im Spiel | rot ×2 → Handfix | 6 / 6 | 31 / 33 | 12 / 10 min |
| P4-1 | Crafting-Rezepte | grün | 0 | 21 | 12 min |
| P4-2 | Rettungsstelle und Sieg (Logik) | grün | 2 | 27 | 23 min |
| P4-3 | Crafting im Spiel | grün | 0 | 47 | 37 min |
| P4-4 | Rettung und Sieg im Spiel | grün | 1 | 43 | 23 min |
| P5-1 | Tag-Nacht (Logik) | grün | 0 | 16 | 14 min |
| P5-2 | Tag/Nacht, Wellen, Nebel im Spiel | grün | 0 | 29 | 10 min |
| P5-3 | Pflanzen im Wind | grün | 0 | 29 | 12 min |
| P5-4 | Geräusche | grün | 0 | 33 | 13 min |
Zusammengefasst: Von den 16 Paketen wurden 14 im ersten Versuch grün; in den Phasen 2 bis 5 sind es 11 von 12 (13 gewertete Läufe). Zählweise: P1a-2 zählt nicht als erster Versuch, weil der erste Lauf verworfen wurde; P4-1 hatte zwei verworfene Vorläufe und zählt trotzdem. Einheitlich gezählt wären es 13 oder 15 von 16. P1a-1 trägt im Ergebnisfeld des damaligen Runners gruen: false, obwohl der Gate-Rückgabecode 0 war und es als grün übernommen wurde – wir führen es als grün, weisen aber darauf hin. Die gesamte Wandzeit der gewerteten Läufe liegt bei rund
6,1 Stunden (Phase 1: 2,8 h, Phase 2: 0,4 h, Phase 3 bis 5: 3,0 h). Dazu kommen verworfene Läufe von zusammen etwa 81 Minuten (p4a-01 43 min, p4a-02 etwa 25 min, p1a2-01 etwa 13 min; siehe 6.2). Den Stromverbrauch haben wir nicht gemessen.
4.4 Was an den Fehlschlägen auffällt
- Zu große Pakete scheitern, kleine laufen. P1a und P1b scheiterten als Ganzes, aufgeteilt liefen sie. Das ist die stärkste Einzelbeobachtung der ganzen Reihe – mit Vorbehalt: Die aufgeteilten Aufgabentexte waren zusammen etwa 50 % länger (P1a 5444 Zeichen gegen 8065, P1b 6308 gegen 8709), p1a-01 bekam weniger Nachschub (2 statt 6), und bei p1a-02 und p1b-01 gab es Kontextüberläufe. Paketgröße und Spezifikationslänge sind also vermischt.
- Nachschub hilft wenig. Wenn das Modell ankündigt statt handelt, bringt ein weiterer Anstoß selten etwas. Ein Lauf mit sechs Nachschüben verbrauchte meist nur wenige Sekunden je Anstoß.
- P3-2 (Einbindung der Überlebenswerte) scheiterte zweimal, jedes Mal anders: Im ersten Lauf stand der Neustart hinter einem
returnund wurde nie erreicht (der erste Lauf hatte 15 rote Checks, darunter fehlende HUD-Balken; derreturnerklärt nur die Neustart-Checks). Im zweiten Lauf hatte das Modell die fünf im Vertrag verlangten Debug-Funktionen schlicht nicht geschrieben. Ein 5-Zeilen-Handfix von mir machte das Gate grün; der Commit-Text nennt ihn. Rein vom Modell erreicht ist P3-2 also nicht. - Danach 8 von 8 beim ersten Versuch (P4-1 ohne seine zwei wegen des Browser-Tests verworfenen Läufe gezählt, sonst 7 von 8). Wir wissen nicht sicher, warum. Plausibel, aber nicht belegt: Wir haben nach P3-2 die Reihenfolge-Details im Frame wörtlich in die Verträge geschrieben.
5. Die Token-Rechnung (Claude)
Für jede Phase wurde gemessen, wie viele Tokens Claude verbraucht hat: für Verträge, Tests, Referenzlösungen, Sichtung der Läufe und Auswertung. Die Messung liest alle Sitzungsprotokolle und zählt jede Antwort einmal (das Protokoll schreibt Antworten mehrfach; ohne Deduplizierung nach Nachrichten-ID wäre alles etwa doppelt so hoch).
| Phase | Claude-Aufrufe | geschrieben | Cache-Lesen | Modell |
|---|---|---|---|---|
| 1 (ab Auftrag) | 122 | rund 98 000 | rund 80 Mio. | Opus 5.5 |
| 2 | 33 | rund 48 000 | rund 8 Mio. | Sonnet 5.5 |
| 3 bis 5 | rund 100 | rund 129 000 | rund 18 Mio. | Sonnet 5.5 |
Die Marken in der Messung sind teils doppelt oder offen (zwei Kettenstarts, ein Neustart). Deshalb sind die Phasen-Summen gerundet; die Gesamtzahl über alles ist sicher, die Verteilung auf Marken nicht. Die Messung ist am Ende offen (die letzte Marke läuft weiter); die Zahlen gelten mit Stichtag 03.11.
Wo die Tokens hingehen. Der größte Block ist nicht der Lauf, sondern die Vorbereitung: Verträge, versteckte Tests, Referenzlösungen und Mutationsproben (in einem einzelnen Abschnitt rund 72 000 geschriebene Tokens für die Phasen 4 und 5 samt Handfix). Die eigentlichen Läufe und ihre Auswertung kosten Claude je Paket nur wenige tausend Tokens.
Der Gegencheck. Der gesamte Code der Phasen 3 bis 5 umfasst etwa 34 000 Zeichen Quellcode und 40 000 Zeichen Tests. Bei grob 3,5 Zeichen je Token sind das etwa 9 600 plus 11 500 Tokens, zusammen gut 21 000. Hätte Claude das direkt geschrieben, wäre es nach dieser Rechnung fünf- bis zehnmal weniger geschriebene Tokens gewesen als der gemessene Weg – eine reine Hypothese aus der Codegröße, ohne den Korrektur- und Interaktionsaufwand (zur Messung an anderen Aufgaben siehe Nachtrag in Abschnitt 10).
Ehrliche Einordnung. Das ist eine Schätzung ohne Gegenmessung; ein Claude-direkt-Lauf wurde nicht gebaut. Preise nennen wir nicht, weil wir sie nicht geprüft haben. Die Phasen 1 und 2+ sind außerdem nur als Mengen vergleichbar, denn das Modell wechselte von Opus auf Sonnet.
Was der lokale Weg tatsächlich tauscht: Claude-Tokens gegen GPU-Zeit, Strom und Fehlversuche. Er lohnt sich eher dort, wo Verträge und Tests ohnehin vorhanden sein müssen – oder wo man den Code nicht aus der Hand geben will. Für ein Wegwerf-Spiel dieser Größe, bei dem Claude Verträge und Tests erst schreiben muss, war er nach unserer Schätzung nicht günstiger.
6. Unsere eigenen Fehler
Ein großer Teil der Arbeit war, den Prüfstand zu reparieren. Das gehört in einen ehrlichen Bericht.
6.1 Harness-Fehler in Phase 1
- Das Ignorieren von
distbeim Kopieren zerstörte diedist-Ordner innerhalb vonnode_modules: ein Lauf musste verworfen werden. /tmpim Gate-Container brauchteexec, sonst liefen Binärdateien nicht.- Der Nachschub-Zähler zählte auch dann, wenn kein Budget mehr da war.
6.2 Der instabile Browser-Test (Phase 4)
Das erste Paket der Kette (P4-1, nur Rezepte) wurde „rot“ – bei korrektem Code und grünen Unit- und Abnahmetests. Ursache: Der Browser-Test aus Phase 3 hatte feste Wartezeiten (300 ms bis 2,2 s), und das
Software-Rendering war zeitweise sehr langsam (laut Notizen 2 bis 11 Bilder/s; das HUD der verworfenen Läufe zeigt 10 bis 12, die niedrigeren Werte sind in den Laufdaten nicht belegt). Das Modell rief pruefe 18-mal auf und scheiterte jedes Mal am Browser-Test (welche Checks rot waren, steht nur in der Schlussprüfung: zwei). Das war ein Fehler des Prüfstands, nicht des Modells.
Beide Läufe sind als verworfen markiert (zusammen etwa 68 Minuten Wandzeit). Die Korrektur: Warten auf Wandzeit und auf eine Mindestzahl gerenderter Frames; danach lief das Paket beim nächsten Versuch grün.
Lehre: Ein Browser-Test gehört vor dem Einsatz gegen eine Referenzlösung bei knapper CPU geprüft – wir haben ihn mit 2 und mit 0,7 CPUs nachgeholt.
6.3 Unerfüllbare Tests
Ein Check („F bei vollem Hunger verbraucht nichts“) war unerfüllbar, weil der Hunger schon im nächsten Frame unter 100 fällt. Die Referenzlösung brachte es ans Licht – ein Grund mehr, nie ohne Referenz zu starten.
6.4 Was Referenz und Mutationsproben gefunden haben
- Bei den Überlebenswerten überlebten zwei von acht Mutationen: beide Grenzfälle bei genau 50. Zwei zusätzliche Tests töteten sie.
- Bei der Einbindung überlebte die Mutation „alte Ressourcen-Gruppe bleibt nach dem Neustart in der Szene“: Der Test sah nur die neue Gruppe. Ein Debug-Zähler für die Gruppen in der Szene schloss die Lücke.
- Das Prinzip dahinter: Eine überlebende Mutation heißt „ungetestet“, nicht „robust“.
6.5 Messfallen
- Jede Antwort steht im Sitzungsprotokoll mehrfach – ohne Deduplizierung verdoppeln sich die Tokens.
- Der Cache-Lese-Anteil dominiert und hängt an der Kontextgröße der Sitzung (in langen Sitzungen rund 650 000 je Aufruf, in frischen etwa zehnmal weniger). Er muss getrennt ausgewiesen werden.
- Offene Marken laufen in die nächste Phase hinein und verschieben Tokens zwischen Abschnitten.
7. Was wir nicht behaupten
- Ein Projekt, eine Reihe. Die Ergebnisse sind Demonstrationen, keine Rangfolgen und keine Aussagen über andere Aufgaben.
- Claude-direkt ist für Lost Island geschätzt, nicht gemessen. Es gibt keinen Parallelbau; gemessen ist Claude direkt nur an den sechs kleineren Aufgaben aus Anhang G.
- Kein Kostenvergleich in Geld für den Lost-Island-Bau. Preise und Strom wurden nicht erhoben. Anhang G enthält getrennte CLI-Kostenschätzungen für sechs kleinere Aufgaben; Strom und Betreuung fehlen auch dort.
- Der Wechsel Opus → Sonnet zwischen Phase 1 und 2 macht die Token-Mengen nur eingeschränkt vergleichbar.
- P3-2 ist nicht rein vom Modell gebaut.
- Sampling nicht fixiert. Weder Temperatur noch Seed wurden gesetzt (Details in Anhang G); ein Lauf ist also nicht exakt wiederholbar.
- Spielqualität: Am Tag sind die Hänge dunkel (die Sonne steht morgens flach), die Nacht ist fast schwarz, und die Kamera taucht am Hang manchmal ins Terrain. Eine 60-FPS-Messung auf echter Hardware steht aus; das Gate rendert per Software mit etwa 10 FPS.
- Die Tests prüfen Verhalten, nicht Spielspaß. Ein erfolgreicher Build und ein grünes Gate beweisen nicht, dass das Spiel gut ist.
8. Das Rezept in zehn Zeilen
- Pakete mit ein bis zwei Dateien; Logik und Einbindung trennen.
- Formeln, Konventionen und Reihenfolgen wörtlich in den Aufgabentext.
- Versteckte Abnahmetests; das Modell bekommt nur ein
pruefe. - Referenzlösung schreiben und das Gate dagegen laufen lassen, bevor die GPU läuft.
- Mutationsproben: Überlebende Mutanten sind fehlende Tests.
- Browser-Test bildratenfest bauen (auf Frames warten, nicht auf Sekunden) und bei knapper CPU prüfen.
- Übernahme automatisch bei Grün, ein Commit je Paket, Gaming-PC danach wieder aus.
- Fehlversuche bleiben im Nenner; verworfene Läufe benennen, nicht verstecken.
- Misstrauen gegen die Abschlusszeile des Harness: das Produkt selbst aufrufen.
- Tokens und Zeit je Abschnitt messen, aber die Messung selbst prüfen (Duplikate, offene Marken, Modellwechsel).
9. Das Gesamtbild seit Anfang Oktober (Anhänge A bis G)
Der Lost-Island-Bau war der Schlusspunkt einer fünfwöchigen Messreihe. Die Anhänge fassen alles zusammen, was seit Anfang Oktober gemessen, getestet und wieder verworfen wurde. Jeder Anhang trennt „demonstriert (n=…)“, „abgesichert“ und „zurückgenommen“, hat einen eigenen Abschnitt für spätere Korrekturen und listet Zahlen, die sich nicht nachprüfen ließen.
| Anhang | Inhalt | Wichtigster Befund (mit Reifegrad) |
|---|---|---|
| A GPU-Ladder und Codegen | Ladder-Drain, Best-of-N, Audit mit Holdout, Wirkungsnachweis, Intake, Spec-Formulierung, K7/K8 | Nach Holm-Korrektur hält keine früher „signifikante“ Aussage, es bleiben Richtungen. Die Stufe 35B:1 → 80B:4 gewinnt im vorab versiegelten Holdout in 78 % der Sechsergruppen, überwiegend durch Ersparnis. Implementierung kostete in zwei Vergleichsrunden 6,2 % bzw. 7,4 % des Claude-Aufwands. |
| B Modelle, Harness, Hardware | 25-Aufgaben-Suite, Quantisierung (IQ3, Bonsai), Strata 125B, Qwen Code, Subagent-A/B, Denkmodus | Auf der Suite liegen 80B, 35B, Strata und Bonsai 2 statistisch nicht unterscheidbar; nur 14b und Bonsai 1 sind nachweislich schlechter als das 35B. Der Harness-Hebel ist in mehreren Messungen größer als jeder Modellabstand (alle Harness-Vergleiche n=1 bis 3). |
| C Piloten und Testgenerator | Pence, Dividenden, K2 bis K8, A1, harte Suite, Absichts-/Rückfragen-/Seed-Arme, Freeze und Holdout | Das 35B brachte mehrere Aufgaben autonom bis „Gate grün“, aber keine ohne Einschränkung freigabefähig: nur K4 bestand das Review ohne Codekorrektur (n=1). Entscheidung 21.10.: Claude-direkt ist Standard, Qwen optional. |
| E Nachträge aus Rohdaten | Testgenerator-MVPs, Strata-Läufe 1 bis 12, Abgleich der Widersprüche aus A bis C gegen Rohdaten | Rohdaten bestätigen die Holm-Werte, Pence-Tokens und K8 49/51; „elf Fehlverdachte an einem Tag“ steht in einem Repo-Dokument, wird dort aber nirgends aufgezählt (einzeln belegt: sechs bzw. sieben). Lauf 12: 35 Züge, teilaufgabe 0×, Leseanteil 60,0 %. |
| F Betrieb, Vorfälle, Projekt-Tests | 24 Vorfälle (19 bis 20 mit belegter Ursache), pve2/Sitter, Sicherheit, Paperless/NAS/Immich, MSFS-Testzahlen | Drei Vorfälle mit offener Ursache (Immich-Tag-Reverts, Shelly, Paperless-Originale 501 bis 504). Testbestände am 03.11.: msfs-mcp 554, cockpit-copilot 513, simtrack 191, pve2-sitter 88. |
| G bench-abc | Claude direkt gegen Hybrid gegen lokal autonom, 6 neue Aufgaben, Replikate, exklusive GPU (04. bis 06.11.) | Claude direkt 6/6 (repliziert 12/12), Hybrid 4/6, lokal 4/6. In den 6 replizierten Zellen (t1, t2, t4) besteht B 5/6 und C 5/6, jeder Arm verliert einen anderen t1-Lauf: der Armunterschied liegt innerhalb der Lauf-zu-Lauf-Streuung. Eine geteilte GPU verfälschte Runde 2 (124 Modellladevorgänge) – --gpu-exclusive ist Pflicht. |
| D OCR, Betrieb, Reviews | OCR-Zweitzeuge, Energie, RAM/CPU, pve2, Review-Sweep über 47 Repos (nachweisbar 46), Testbestände | Plausibilitätsmaße für OCR scheiterten, ein Zweitzeuge (frisches tesseract) funktionierte: 18/18 bestätigt. Wohnzimmer 35,5 kWh in 7 Tagen. Review-Sweep: 9 High-Funde, alle behoben. |
Was sich durch alle Reihen zieht
- Der Prüfstand war oft der Schuldige, nicht das Modell. In den Anhängen B und C sah mehrfach ein Harness- oder Orakeldefekt wie Modellversagen aus (Lesedeckel, Router-Template, Marker-Diagnose, Denkmodus). In diesem Projekt war es der instabile Browser-Test.
- Der Reifegrad ist fast überall niedrig. Fast alle Messreihen haben n=1 bis n=25 und einen Seed. In Anhang A hält nach der Holm-Korrektur keine Signifikanz; wir sprechen von Richtungen, nicht von Siegern.
- Der Harness schlägt oft das Modell. In Anhang B ist der Harness-Hebel in mehreren Messungen größer als jeder Modellabstand, in Anhang C wirkt Spezifikation und Konventionswissen stärker als Modellgröße.
- Gates melden „grün“ oder schweigen, während etwas kaputt ist (Anhang D: Dry-Run, Hook, Cron mit Exit 0). Deshalb gilt: das Produkt selbst aufrufen.
- Auch die eigenen Berichte mussten korrigiert werden. Anhang A listet 14 zurückgenommene Aussagen, Anhang C 13, Anhang D 14 – darunter ein Break-even „b=2“, ein „strikt dominant“ und ein Kostenvorteil gegen einen erfundenen Preis.
Bekannte Widersprüche in den Quellen
Die Anhänge benennen sie einzeln; hier die wichtigsten: Per Rohdaten aufgelöst (Anhang E, F): Der Wert für B gegen I steht je nach Quelle als 0,016, 0,02 und 0,015625, weil zwei Holm-Familien (5 und 12 Tests) existieren; beide wurden neu gerechnet und stimmen. Das K8-Orakel: 49/51 ist belegt, 48/51 ist die unkorrigierte Altangabe. Sonnet hat drei Messläufe (20/25, 22/25, 24/25). Pence Lauf 1: beide Token-Zahlen stimmen, sie zählen verschieden. msfs-mcp 269 gegen 441 Tests: kein Widerspruch, sondern ein Log mit veralteter Kopfzeile; heute 554. Claude-Tageslimit 300 gegen 0: zeitlicher Verlauf, am 04.10. auf 0 gesetzt.
Weiterhin offen: Die „3,06 $ reale Kosten“ wurden zur CLI-Schätzung korrigiert. Ob die teuren Nächte beim Strom auf den Gaming-PC zurückgehen, ist nicht hart belegt, weil Logs fehlen. Die Ursache des Anstiegs der laya-Aufrufe steht nirgends. Der Jellyfin-Unterschied (1375 gegen 1372) ist nur arithmetisch erklärt. Der 35B-Arm des Forensiklabor-Duells (8/11) fehlt in logs/codegen-stats.jsonl. Alles auf dem Gaming-PC (Strata-Benchmark) war nicht erreichbar.
Live-Stand am 03.11.: Der Router meldet auto_shutdown.enabled: true; der Memory-Index führt das noch als „war false, offen“.
Wie die Anhänge entstanden
Sechs Teilagenten haben die Memory-Notizen seit Anfang Oktober gelesen (vier für die Anhänge A bis D, zwei weitere für die Lücken in E und F; E rechnet außerdem Zahlen aus den Rohdaten neu), Zahlen wörtlich übernommen und je einige Werte gegen Rohdaten nachgeprüft (zum Beispiel Best-of-N-Zählungen, Holdout-Werte, Bonsai-Wiederholungsläufe, OCR-Goldfile, specdec-Messung).
Ich habe zusätzlich die Zählung der Suite vom 15.10. selbst gegen die Rohdatei nachgezählt. Die Lost-Island-Tests habe ich selbst am 03.11. ausgeführt (237 Tests in 11 Dateien, alle grün). Eine Wiederholung der gesamten scripts/-Suite habe ich nicht abgeschlossen: Sie lief über das Zeitlimit von 590 s hinaus; ein früherer Lauf mit -x stoppte am ersten Fehlschlag in scripts/experiments/orakel-lokal-v2/test_orakel_entwurf_v2.py::test_signatur_stimmt_mit_dem_bestandsmodul_ueberein. Die übrigen Zahlen stammen aus den Notizen und Rohdaten, nicht aus neuen Läufen. Vor einer Veröffentlichung sollte jemand die Zahlen mit dem Rohmaterial abgleichen, die einem Leser besonders wichtig sind.
10. Nachtrag 6. November: Was Anhang G am Fazit ändert
Nach dem Lost-Island-Bau haben wir die Frage direkt gemessen: sechs neue, kleine Python-Aufgaben mit versteckten Tests, drei Verfahren (Details und Grenzen in Anhang G).
| Verfahren | bestanden | Claude-Kosten (CLI-Schätzung, 6 Aufgaben) | Dauer bis grün |
|---|---|---|---|
| Claude direkt | 6 / 6 (im Replikat wieder 6 / 6) | 0,80 USD | 0,3 bis 2 min je Aufgabe |
| Hybrid (Claude-Vertrag, Qwen setzt um) | 4 / 6 | 1,23 USD (nur Planer) | 12 bis 76 min je Aufgabe, 238 min Wandzeit auf der GPU |
| Lokal autonom | 4 / 6 | 0 USD | 8 bis 80 min je Aufgabe, 251 min Wandzeit auf der GPU |
Die Kosten sind Schätzungen des CLI, keine Rechnung; die Zeiten sind Wandzeit, nicht GPU-Auslastung (die haben wir nicht gemessen). Zwölf von 18 Zellen haben zwei gültige Läufe (alle Claude-direkt-Zellen sowie Hybrid und lokal auf t1, t2, t4), sechs nur einen.
Was das am Fazit der Lost-Island-Reihe ändert:
- Das lokale 35B ist unter einem geeigneten Harness ein brauchbarer Implementierer begrenzter, getesteter Aufgaben. Lost Island zeigt das an einem zusammenhängenden Spiel.
- Es ist kein Beleg dafür, dass ein lokales Modell einen Cloud-Coding-Agenten allgemein ersetzt. Die Aufgaben waren vorbereitet, zerlegt und durch versteckte Tests abgesichert; diese Vorbereitung war der größte Aufwandsblock (Abschnitt 5).
- Der Vertrag (Hybrid) half in den replizierten Zellen nicht erkennbar: Hybrid und lokal bestanden dort je 5 von 6, jeder Arm verlor einen anderen Lauf. Das Replikat deckt nur die leichten und mittleren Aufgaben ab (t1, t2, t4).
- Die Token-Hypothese aus Abschnitt 5 bleibt eine Hypothese. Gemessen ist nur, dass Claude direkt kleine Aufgaben in wenigen tausend Output-Tokens löst, nicht der Aufwand für ein Spiel dieser Größe.
- Ein grünes Gate heißt nicht merge-fähig. Im verblindeten Review (subjektiv, je Aufgabe ein Prüfer) lag die lokale Lösung im Mittel unter den anderen, und in t6 bestand sie das Gate, obwohl ein kaputter Tool-Call Dateien mit Müllnamen im Paket hinterlassen hatte. Das Gate prüfte nur Verhalten; ein Review oder eine Prüfung auf Dateimüll bleibt nötig.
- Der Prüfstand hat auch uns selbst getroffen. Instabiler Browser-Test, ein Harness-Fehler beim Kopieren, GPU-Konkurrenz in Runde 2, unterzählte Output-Tokens, ein Orakel-Marker mit Fehlalarm: Jeder dieser Fehler sah zunächst wie ein Ergebnis aus. Dass sie auffielen, ist für andere vermutlich der übertragbarste Teil dieser Arbeit.
- Offen ist ein anderes Betriebsmodell, in dem das lokale Modell auch plant und Claude nur eskaliert. Die Teilmessungen dazu (Anhang A) sind noch kein Vergleich der Gesamtkosten bis zur abgenommenen Änderung. Die ökonomisch entscheidende Größe wäre genau diese Gesamtgröße (inklusive Tests, Prüfstand, Strom und Betreuung), nicht der Preis eines Tokens. Gemessen sind bisher nur die Claude-API-Schätzung und die Laufzeit; im Benchmark gewann Claude direkt bei beidem.
Anhang: Wo die Daten liegen
| Was | Pfad |
|---|---|
| Spiel-Repo (eigenes Git) | compose/lost-island/ |
Läufe je Paket (ergebnis.json, Mitschnitte, Nachschubtexte) |
run/lost-island/laeufe/ |
| Pläne, Verträge, versteckte Tests | run/lost-island/PLAN-P3-P5.md, run/lost-island/p*/AUFGABE.md, run/lost-island/p*/orakel/ |
| Generatoren der Verträge und Orakel | run/lost-island/phase3/ |
| Tokenmessung und Marken | run/lost-island/phase2/tokenmessung.py, phase2/marken.txt |
| Screenshots | run/lost-island/shots/final/ |
| Harness-Vergleiche (Vorgeschichte) | run/harness-vergleich/, run/opencode-echt*/ |
| Runner | scripts/opencode-lauf.py, scripts/opencode_lauf/ |
| Live | im Heimlabor hinter Authelia (Homepage, Gruppe „Spiele“) |
Die Detailkapitel: Anhang G – bench-abc · Anhang E – Nachträge aus Rohdaten · Anhang F – Betrieb, Vorfälle, Projekte · Anhang A – GPU-Ladder und Codegen · Anhang B – Modelle, Harness, Hardware · Anhang C – Piloten und Testgenerator · Anhang D – OCR, Betrieb, Reviews
Was weiterhin nicht abgedeckt ist
- Von den 184 Notizen seit dem 01.10. fehlen reine Arbeitsregeln und Bedienhinweise ohne Messung bewusst.
msfs-mcp-sim-befunde.md(rund 1 160 Zeilen) wurde nur in Auszügen gelesen, ebenso die Mitte vonsecurity-agent.- Mutationsscores und
logs/testgen/vergleich-*wurden nicht geöffnet; kleine Abweichungen bei den Strata-Läufen 5, 6 und 7 (19 gegen 18 Züge, 33 gegen 34) sind nicht geklärt. - Es wurden Memory-Notizen und Rohdaten im Repo ausgewertet, nicht die Git-Historie der einzelnen Projekte.
- Der Gaming-PC war für Rohdaten (Strata-Benchmark, hipBLASLt-Ergebnis) nicht erreichbar.